Масштабування робочих навантажень Kubernetes за допомогою node swap
Памʼять часто є першою жорсткою межею, у яку впирається кластер Kubernetes. Вузли вичерпують оперативну памʼять (RAM) задовго до того, як вичерпають ресурси CPU, а нова хвиля агентних AI-робочих навантажень робить це ще гіршим. Такі навантаження вимагають великих обсягів памʼяті для запуску та виконання ненадійного коду, а потім простоюють, очікуючи наступного запиту. Ця простоююча, але резидентна памʼять є дорогою, і вона обмежує, скільки Podʼів може вмістити вузол. Тут і допомагає swap. Підтримка Kubernetes для запуску вузлів з увімкненим swap досягла загальної доступності у v1.34, і, розмістивши цей swap на швидких NVMe твердотілих накопичувачах (SSD), вузол може вивантажувати неактивну памʼять та вміщати значно більше Podʼів. Ця публікація пояснює, як ми тестували такий підхід на трьох типах робочих навантажень, зокрема CI/CD конвеєрах збірки ядра, пісочницях headless-оглядачів та ізольованих Python-середовищах; ми виявили збільшення щільності до 3×, часто з незначною вартістю затримки або без неї.
Проблема щільності вузлів
Екосистема Kubernetes досягла фундаментального обмеження фізичних ресурсів: жорсткі межі апаратної памʼяті проти зростаючого попиту на динамічні, імпульсні робочі навантаження в нову агентну епоху.
Історично склалося так, що адміністратори, які налаштовували ресурси для ресурсоємних робочих навантажень, стикалися з постійною дилемою: якщо встановити занадто високі обмеження памʼяті, то дорога інфраструктура марнується на незайняту оперативну памʼять; якщо ж встановити занадто низькі обмеження, то виникає ризик примусового завершення процесів через нестачу памʼяті (Out-Of-Memory, OOM).
Цей конфлікт посилюється при розгортанні автономних AI-агентів із використанням безпечних середовищ виконання, таких як фреймворк agent-sandbox. Такі агентні Podʼи потребують великих обсягів памʼяті для ініціалізації та виконання ненадійного коду. Однак після сплеску активності вони зазвичай переходять у довготривалі фази простою в очікуванні запитів користувача. Утримання цього простою у фізичній RAM обмежує щільність кластера та робить AI-інфраструктуру дорогою в експлуатації.
Рішення: node swap у Kubernetes
З впровадженням у Kubernetes підтримки роботи вузлів із увімкненим swap (яка досягла загальної доступності у v1.34) ця парадигма змінюється. Дозволяючи ядру Linux вивантажувати анонімну памʼять на диск, node swap виконує роль амортизатора під час пікових навантажень або періодів значного перевантаження памʼяті.
Історично swap не рекомендувався в Kubernetes з двох причин. Перша — облік памʼяті. За cgroup v1 елементи керування розглядали памʼять і swap як єдине комбіноване обмеження, а не дозволяли операторам встановлювати незалежне обмеження для дискового swap. Без незалежного відстеження процес міг вивантажувати великі обсяги анонімної памʼяті на диск, що робило реальне використання памʼяті контейнера непередбачуваним і важко ізольованим. Підтримка swap у Kubernetes вирішує це, покладаючись на cgroup v2, чий окремий облік swap відстежує дисковий swap самостійно. Другою причиною було зниження продуктивності через затримки при обміні даними з повільними обертовими дисками, що в значній мірі усувається завдяки швидким локальним SSD-накопичувачам NVMe. Разом це робить практичним збільшення щільності Podʼів і буферизацію сплесків памʼяті без шкоди для стабільності кластера.
Дані тестування
З метою кількісної оцінки меж продуктивності та потенціалу зниження витрат node swap на основі локальних SSD-накопичувачів цей аналіз охоплює три окремі категорії робочих навантажень: традиційні навантаження збірки для конвеєрів CI/CD, пісочниці високої щільності для веб-оглядачів та ізольовані Python-пісочниці.
| Профіль навантаження | Базова ємність (без swap) | Ємність з локальним SSD swap | Покращення щільності |
|---|---|---|---|
| CI/CD збірка ядра Linux | Обмеження RAM 600 МБ | Обмеження RAM 300 МБ | -50% обсягу RAM |
| Headless Chrome (Kata) | 40 одночасних Podʼів | 50 одночасних Podʼів | +25% до щільності Podʼів |
| Headless Chrome (gVisor) | 80 одночасних Podʼів | 160 одночасних Podʼів | +100% до щільності Podʼів |
| Python-пісочниця (gVisor) | 80 одночасних Podʼів | 240 одночасних Podʼів | +200% до щільності Podʼів |
1. Традиційне навантаження: збірка ядра Linux
Перш ніж досліджувати спеціалізовані агентні архітектури, ефективність swap була перевірена на класичних пакетних навантаженнях шляхом запуску повної збірки ядра Linux 6.1.1. Процес компіляції ядра використовує паралельні робочі потоки, різко збільшує обсяг памʼяті для зберігання скомпільованих обʼєктних файлів і вимагає значного сплеску споживання памʼяті під час короткої фази лінкування.
Це навантаження відтворює поведінку памʼяті корпоративних CI/CD конвеєрів. Оскільки раніше скомпільовані обʼєкти залишаються неактивними у памʼяті, поки конвеєр просувається, завдання CI/CD часто накопичують невикористану фізичну RAM, що робить їх добре придатними для стиснення node swap.
На базовому вузлі без swap мінімальне обмеження памʼяті для запобігання збою OOM під час компіляції становило 600 МБ. Перенаправлення swap на локальний SSD скоротило обмеження памʼяті контейнера на 50% до 300 МБ без жодного уповільнення виконання (насправді воно пройшло чисто за 374 с проти базових 433 с). Однак, як очевидний компроміс, подальше стиснення обмеження до 200 МБ змусило активний робочий набір вивантажуватися в swap, спричинивши тривалий час очікування вводу/виводу та збільшивши час виконання більш ніж на 40%. Це підтверджує, що swap слугує запобіжним засобом на випадок раптового сплеску потреби у памʼяті, а не заміною активної RAM.
2. Високощільні агентні навантаження: середовища headless-оглядачів
AI-агентні навантаження часто вимагають керування headless-оглядачами через Chromium. Однак довіра до виконання зовнішнього коду часто вимагає суворішої ізоляції безпеки, ніж стандартні простори імен Linux. Це тестування порівняло кілька середовищ виконання контейнерів. Сирі логи та методології тестування для типового середовища виконання доступні в теці Agent Sandbox GKE Swap.
- Базові межі без пісочниці (
runc): Щоб перевірити межі середовища без накладних витрат на безпечні середовища виконання, звичайні runc-контейнери запускалися на вузлі c4-standard-32 (32 vCPU, 120 ГБ RAM). Без swap вузол вичерпав фізичну памʼять і давав збій, коли кількість Podʼів перевищувала 512. Увімкнення локального SSD swap дозволило вузлу підтримувати роботу 768 Podʼів одночасно. - Розширені безпечні середовища виконання (наприклад: gVisor, Kata Containers): Увімкнення суворої ізоляції безпеки збільшує накладні витрати памʼяті та зазвичай знижує щільність Podʼів. Однак swap памʼяті природно поглинає цю плату за накладні витрати. Без swap середовище gVisor досягло жорсткої межі на 80 Podʼах. Локальний SSD swap подвоїв цю ємність, дозволивши роботу 160 gVisor Podʼів одночасно на одному вузлі. Так само мікроВМ Kata Containers вичерпали фізичну RAM на 40 одночасних Podʼах без swap, але використання локального SSD swap на GCP розширило це до 50 стабільних Kata мікроВМ до насичення CPU.
За цих максимальних щільностей збільшення затримки на Pod зумовлене головним чином конкуренцією Podʼів за CPU, а не вводом/виводом swap. Оператор, який налаштовується на конкретний цільовий показник затримки, працював би за нижчої щільності, ніж пікові значення тут, і бачив би пропорційно меншу вартість затримки.
Для вичерпного архітектурного аналізу та метрик щільності для gVisor і Kata дивіться теку Agent Sandbox GKE Swap Runtimes.
3. Поза оглядачами: пісочниці Python
Переваги node swap також поширюються на ненадійні, ізольовані середовища виконання коду. Це тестування розгорнуло одночасні Python-пісочниці, які аналізували 5 мільйонів рядків даних з набору даних MovieLens 20M, потребуючи ≃375 МіБ резидентної памʼяті на кожне виконання. Детальні результати масштабування та код розгортання для цього тесту можна переглянути в теці Agent Sandbox GKE Swap Python Density.
Без swap важкі одночасні сплески вичерпували фізичну памʼять, спричиняючи досягнення вузлом жорсткої межі RAM та збій на 80 одночасних сесіях. Увімкнення локального SSD swap вивантажило неактивну анонімну памʼять, звільнивши фізичну RAM та зберігши кеш сторінок вузла. Це дозволило вузлу масштабуватися до 240 одночасно ізольованих Python-пісочниць — покращення щільності у 3 рази. Як і з навантаженнями вебоглядачів, зростання затримки на піковій щільності походить головним чином від конкуренції пісочниць за CPU, а не від самого swap.
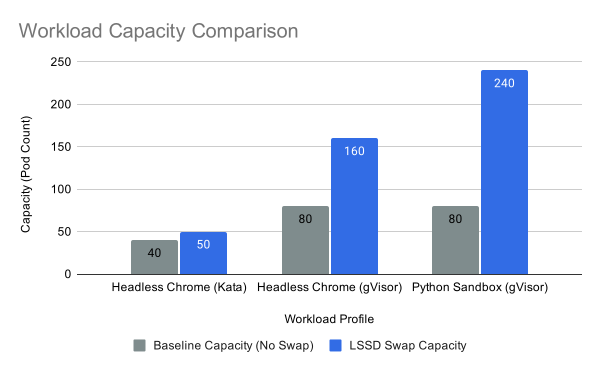
Тести щільності з node swap та без нього
Як цим користуватися
Якщо ви керуєте Kubernetes-інфраструктурою для середовищ розробників, ферм тестування вебоглядачів, JVM-застосунків або AI-середовищ виконання, використання локального SSD swap може підвищити вашу ефективність щільності в рази.
У Kubernetes v1.34+ node swap є загальнодоступним. Ви вмикаєте його через конфігурацію kubelet:
kind: KubeletConfiguration
apiVersion: kubelet.config.k8s.io/v1beta1
failSwapOn: false
memorySwap:
  swapBehavior: LimitedSwap
Поєднання цієї upstream-конфігурації з високошвидкісним локальним диском вашого хмарного провайдера дає вам динамічний баланс памʼяті. Наприклад, це нативно підтримується в Google Kubernetes Engine через Node Memory Swap, налаштований на профілях локальних SSD.
Щоб скористатися цими перевагами, налаштуйте свої робочі навантаження з використанням Burstable QoS: встановіть для контейнера обмеження памʼяті, що перевищують його запити. Вузол автоматично розподіляє швидкий простір swap на основі використання памʼяті застосунків у режимі простою, забезпечуючи при цьому оперативну реакцію активних процесів.
Висновок
У міру переходу екосистеми Kubernetes в еру агентів адміністратори стикаються з дедалі гострішим конфліктом між обмеженими обсягами апаратної памʼяті та імпульсним характером роботи робочих навантажень штучного інтелекту. Такі фреймворки, як Agent Sandbox, забезпечують ізоляцію безпеки, необхідну для запуску ненадійних агентів, але така ізоляція традиційно вимагає значних витрат на незайняту памʼять.
Налаштувавши kubelet з LimitedSwap та спрямувавши його на локальні SSD, ви можете помʼякшити цей конфлікт. Швидкий swap вивантажує неактивні стани агентів, що простоюють, дозволяючи вам збільшувати щільність Podʼів та використання вузлів на тій самій інфраструктурі без порушення меж безпеки.